
教學:用 llama.cpp 在本機運行 GGUF 模型
llama.cpp 是一個以純 C/C++ 寫成的 LLM 推理引擎,專為在本機運行 GGUF 格式的量化模型而設。它不需要 Python 環境或雲端 API,同一份 GGUF 檔案可以跑在 CPU、NVIDIA(CUDA)、Apple Silicon(Metal)、AMD/Intel(Vulkan)等不同硬件上。本文按官方 README 與 docs 整理:安裝、取得模型、以 llama-cli 及 llama-server 運行,最後用 OpenAI 兼容端點驗證。以下步驟對應的版本以官方 master 及 nightly release b11748(2026-10-20)為準。
先決條件
- 作業系統:Linux、macOS 或 Windows。本文命令以 Linux/macOS(bash)為例,Windows 對應
llama-server.exe。 - 若自行編譯:CMake 3.14 以上、C++17 編譯器(gcc/clang),GPU 加速另需對應的驅動與工具鏈(CUDA Toolkit、Metal、Vulkan SDK)。
- 記憶體:模型大小 × 量化比例 + 上下文佔用。Q4_K_M 級別的 7B–9B 模型大約需要 6–8GB RAM/VRAM;先由小模型開始試最穩妥。
第一步:安裝 llama.cpp(四選一)
(A)官方預編譯二進制:到官方 releases 頁下載對應平台的壓縮包,或使用官方安裝腳本(README 的 Quick start):
curl -LsSf https://llama.app/install.sh | sh(B)套件管理器:macOS/Linux 用 Homebrew,Windows 用 Winget,跨平台可用 conda-forge(官方 install.md 列出):
brew install llama.cpp        # macOS / Linux
winget install llama.cpp      # Windows
conda install -c conda-forge llama.cpp(C)Docker:官方提供已編譯映像(server/server-cuda 等變體),適合不想安裝工具鏈的環境:
docker run -p 8080:8080 -v /path/to/models:/models ghcr.io/ggml-org/llama.cpp:server
-m models/7B/ggml-model.gguf -c 512 --host 0.0.0.0 --port 8080(D)由原始碼編譯(想要最新功能或指定 GPU 後端時使用;以下為官方 CPU 編譯路線):
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
cmake -B build
cmake --build build --config Release
要啟用 NVIDIA GPU 加速,在 configure 階段加上官方選項(其餘 Metal/Vulkan/HIP 等見官方 docs/build.md):
cmake -B build -DGGML_CUDA=ON
cmake --build build --config Release
第二步:取得 GGUF 模型
llama.cpp 只讀 GGUF 格式。就算你手上沒有模型檔,也可以直接用 -hf 參數讓它由 Hugging Face 下載並運行(官方 docs/models.md):
llama-cli -hf ggml-org/gemma-3-1b-it-GGUF格式為 -hf <user>/<model>[:quant],可在 Hugging Face 以 library=gguf 篩選相容模型;也可以自行用 huggingface-cli 下載後,以 -m /path/to/model.gguf 指向本機檔案。首次運行 1B 級別的小模型最快見到效果。
第三步:運行與驗證
(A)命令列一次性問答(llama-cli):
llama-cli -m models/qwen-8b-Q4_K_M.gguf -p "用一句話解釋 GGUF 是甚麼" -n 200加 -cnv 可進入連續對話模式。GPU 加速以層數控制,-ngl 99 代表盡量把層放入 GPU(VRAM 不足就調低):
llama-cli -m models/qwen-8b-Q4_K_M.gguf -ngl 99 -c 8192 -cnv(B)OpenAI 兼容 API 伺服器(llama-server):
llama-server -m models/qwen-8b-Q4_K_M.gguf -c 8192 -ngl 99官方文件說明:伺服器預設監聽 127.0.0.1:9931(注意不是 8080),可以用 --host 與 --port 更改;同一個網址也是內建 Web UI。提供的 OpenAI 兼容端點包括 /v1/models、/v1/completions、/v1/chat/completions。
驗證(官方 curl 範例格式):
curl http://localhost:9931/v1/chat/completions
  -H "Content-Type: application/json"
  -d '{"messages":[{"role":"user","content":"用一句話說明你在本機運行"}],"temperature":0.2}'
任何兼容 OpenAI SDK 的客戶端,只要把 base_url 指向 http://127.0.0.1:9931/v1 就可直接使用本機模型。
安全與實務注意
--host 0.0.0.0會把模型服務開放給同網絡所有裝置;官方提供--api-key(可多條)作認證。除非有反向代理與認證,否則保持預設127.0.0.1。- 上下文愈大愈吃記憶體:
-c直接影響 KV cache 佔用,先在 4096–8192 之間試。 - 量化級別愈低愈省記憶體但質素下降;Q4_K_M 是多數情況的平衡點(此為社群慣例,非官方保證)。
常見載入錯誤(對應症狀)
- unknown model architecture:GGUF 用上比你的 llama.cpp 更新的架構。更新 llama.cpp 到最新版本,別無他法。
- Out of memory:降一級量化、減少
-ngl,或縮小-c。 - magic number/metadata 錯誤:下載檔案不完整或損壞,重新下載並核對 Hugging Face 頁面顯示的 SHA256。
- 找不到模型檔案:
-hf需要網絡可達 Hugging Face;離線環境請改用-m指向已下載檔案。
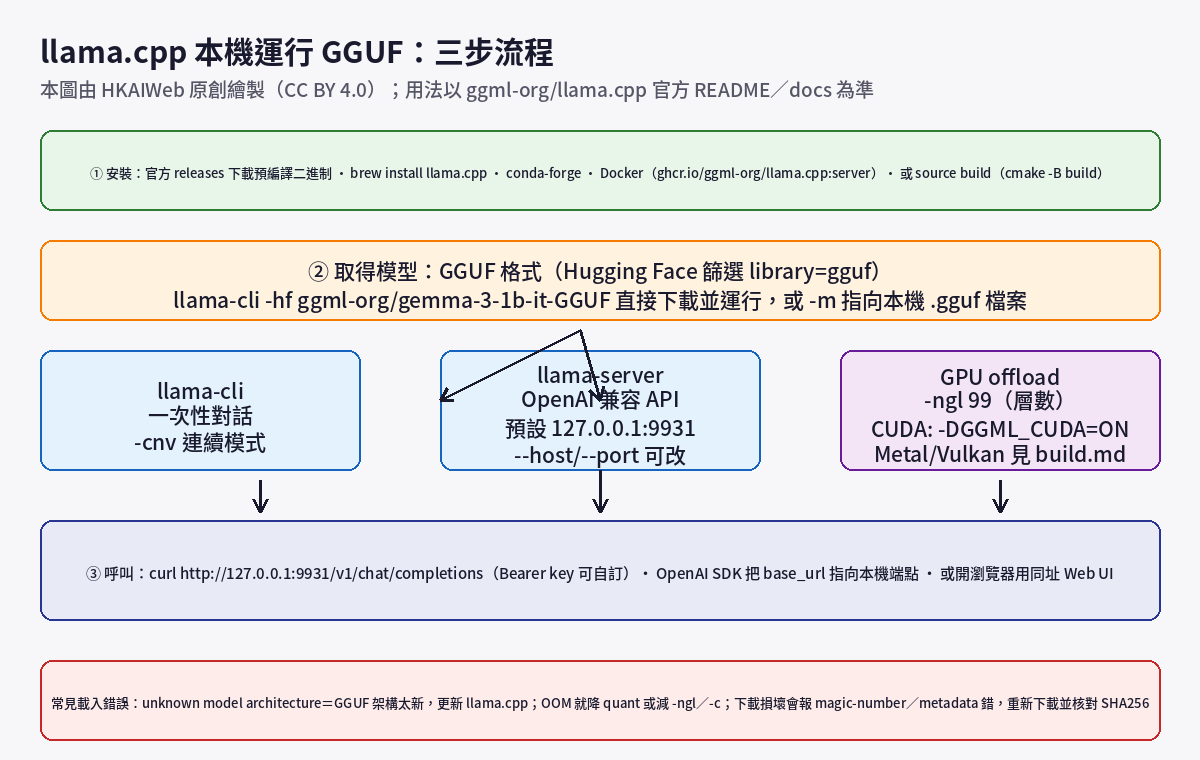
圖片來源及授權:本圖為 HKAIWeb 原創繪製(CC BY 4.0),非官方素材;可自由轉載並註明來源。
來源
- 官方 repository:github.com/ggml-org/llama.cpp
- 官方 README(Quick start、安裝選項):raw.githubusercontent.com/ggml-org/llama.cpp/master/README.md
- 官方 build 文件(CPU/CUDA/Metal/Vulkan 編譯):docs/build.md
- 官方 install 文件(brew/winget/conda-forge):docs/install.md
- 官方模型文件(-hf 下載、GGUF 說明):docs/models.md
- 官方 server 文件(參數、預設 127.0.0.1:9931、OpenAI 兼容端點、Docker 範例):tools/server/README.md
- 獨立交叉參考(非第一手):docs.privategpt.dev、yuseokkang.com、vucense.com、dev.to