
語音代理(voice agent)過去要拼湊多個供應商:一家做語音轉寫(STT)、一家做推理、一家做語音合成(TTS),每段之間各自承擔延遲與整合成本。Mistral 在 2026 年 10 月 20 日發布的 Voxtral 3,試圖把這三塊放進同一條實時串流管線。
第一手公告實際說了甚麼
Mistral 官方新聞稿把 Voxtral 3 定位為「新一代語音轉寫與語音合成模型家族,加上一個把聆聽、思考、工具呼叫與說話放進同一實時串流管線的語音代理 SDK」。官方指出,可靠的語音代理必須同時做好四件事:跨語言、口音、說話者與打斷情況下準確聆聽;在特定上下文中深入推理意圖;自然地帶情感與表達地說;以及透過連接的系統跨多個步驟執行行動。
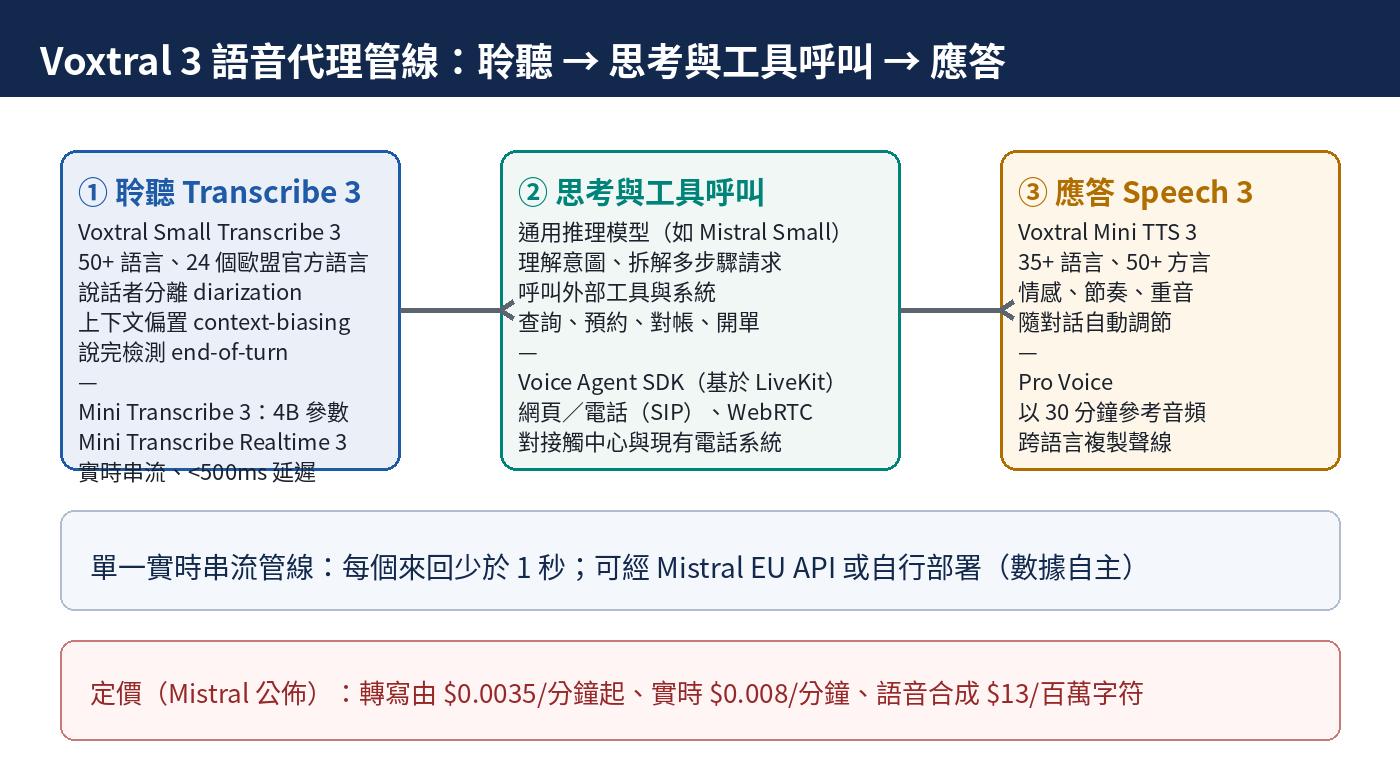
① 聆聽:Transcribe 3
- Voxtral Small Transcribe 3:官方稱在多語言轉寫上達到同級最佳,支援 50+ 語言(包括 24 個歐盟官方語言,以及較少資源的亞洲與印度語言),具備說話者分離(diarization)、以關鍵詞提升專有名詞準確度的上下文偏置(context-biasing),以及「說完檢測」(end-of-turn detection)——讓代理知道何時可以接話。
- Voxtral Mini Transcribe 3:官方文件註明為 40 億(4B)參數,官方稱具 32K token 上下文窗口。
- Voxtral Mini Transcribe Realtime 3:為代理設計的實時串流轉寫,官方稱延遲低於 500 毫秒,即在使用者詞彙與說話者分離時亦然。
② 思考與工具呼叫
管線中段由通用推理模型(如 Mistral Small)負責理解意圖、拆解多步驟請求,並呼叫外部工具與系統。官方列出的應用場景包括服務台、虛擬助理與免提副駕駛,代理可在對話中查詢資料、與業務系統對接,並執行涉及多個步驟的任務。
語音代理 SDK 建於 LiveKit 之上,把實時轉寫模型、推理模型與語音合成模型串成一條管線;代理可處理 SIP 通話,並可在瀏覽器與應用程式中透過 WebRTC 運行,連接既有電話系統與客服中心軟件。Mistral 亦稱整套流程「每次來回少於 1 秒」,但官方公告未附可獨立重現的端到端延遲測試數據,本文按廠商說法標示。
③ 應答:Speech 3
- Voxtral Mini TTS 3:Mistral 新聞稿稱支援 35+ 語言、50+ 方言,會按對話上下文調節情感、節奏與重音,亦可以標籤逐行指定(例如 [emotion=sad][pace=slow] 一類設定)。需注意同日官方 TTS 3 模型卡寫「Supports 9 languages」,兩者數字不同;該模型卡亦標示為 Public Preview Premier v3.0,即仍屬預覽階段的託管供應。引用時請以模型卡為準。
- Pro Voice:Mistral 新聞稿稱可「using just 30 minutes of audio」複製說話者的聲線、情感表達與風格;官方 Voices 文件對自訂語音建議收集 30 分鐘至 3 小時錄音,並非 30 分鐘上限。
定價
多家媒體從 Mistral 定價頁取得的數字一致:轉寫由每分鐘 0.0035 美元起(Small 為 0.0040 美元、實時版 0.008 美元),語音合成為每百萬字符 13 美元。Mistral 稱此價格低於 OpenAI TTS-1、Deepgram、ElevenLabs Flash 與 Gemini Flash 的同類服務。 Artificial Analysis 的獨立比較亦顯示,Voxtral 3 TTS 定價低於 Gemini 3.8 Flash TTS(每百萬字符 16.5 美元)與 ElevenLabs v4 Turbo(40 美元),但高於 Simba 3.2(6.6 美元)。
獨立評測怎麼說
Artificial Analysis 對整個家族進行了實測,其公開結果(非 Mistral 自評)顯示:
- 語音轉寫:Voxtral Small Transcribe 3 在其語音轉寫排行榜位列第 3,AA-WER Index 為 2.1%,略優於 ElevenLabs Scribe v2(2.2%)與 Grok Voice Transcribe 2.0(2.3%);Voxtral Mini Transcribe 3 位列第 5(2.2%)。
- 串流轉寫:Voxtral Mini Transcribe Realtime 3 在 960 毫秒設定下取得 3.3% final-transcript AA-WER(46 個模型中第 6),480 毫秒設定下為 3.6%,較上一代 Voxtral Mini Transcribe Realtime 的 5.2% 有改善。
- 語音合成:其所測的 Voxtral 3 TTS 在兩個文本轉語音競技場均位列第 12(2026-10-20 收集時快照;AA 排名屬動態資料,會隨新模型上架變動)。
需要留意:這些排名衡量個別模型能力,並不衡量整條代理管線的端到端表現。Artificial Analysis 亦明確指出這一點。
為何值得 HKAIWeb 讀者留意
對開發者而言,真正的變化不是單一模型的分數,而是整合面。把 STT、LLM、TTS 三個供應商收成一條 SDK,意味着少了兩個整合點,也少了兩段各自累積的延遲;配合 LiveKit 對 WebRTC 與 SIP 的支援,從瀏覽器 demo 走到客服中心電話線的門檻也隨之降低。對香港及亞洲讀者特別的一點是:新版轉寫明確擴展至較少資源的亞洲與印度語言,粵語、普通话等場景的實際表現雖未見獨立基準,但方向明確。
另一個值得留意的是部署選擇。Mistral 把 Voxtral 3 歸類為「主權部署」——可經歐盟託管的 API 使用,也可在自家基礎設施上運行,讓機構自行決定音頻在哪裡處理、數據如何處理、對話是否保留。對需要控制音頻處理地點、數據處理與對話保留方式的機構,這是實質的部署控制項;但可自行部署本身不等於符合 PIPL、GDPR 或香港 PDPO,各地要求不同,合規評估需另行進行。
限制與未確定事項
- 初步判定並非開放權重,但官方未發佈 blanket 聲明。已核實 Mini TTS 3、Mini Transcribe 3 模型卡均標為 Public Preview Premier v3.0,屬託管/API 供應類別;多篇報導與社群討論亦指出 Voxtral 3 系列不是 open-weight 模型。「可自行部署」不等於開源,自建仍需遵守 Mistral 的授權條款。
- 同級最佳說法屬官方自評。「state-of-the-art」「outperforms Whisper、Scribe v2 與 Gemini 3.5 Transcribe」等表述來自 Mistral;第三方數據目前主要來自 Artificial Analysis,且僅覆蓋個別模型而非完整管線。
- 延遲數字為官方值,未見獨立端到端測試。「sub-500ms」見於 Realtime 3 說明;「每次來回少於 1 秒」亦為 Mistral 說法,本文未找到可獨立重現的端到端測量,不作為端到端承諾。
- 實際噪音與口音表現需自行實測。社群建議以自家最差的通話錄音(含口音、背景噪音、多人插話)作實測,而非依賴基准分數。
來源
- Mistral 官方新聞稿:Voxtral 3 — Voice Agent SDK & Speech Models in 50+ Languages
- Mistral 音頻模型官方文件
- Artificial Analysis:Voxtral Small Transcribe 3 模型頁(含 AA-WER Index 與排名,2026-10-20 快照)
- Artificial Analysis:TTS Controlled Voice 排行榜(Voxtral 3 TTS 排名來源)
- Mistral 官方 TTS 3 模型卡(語言數與預覽狀態)
- Mistral 官方 Voices 文件(自訂語音建議錄音時長)
- Artificial Analysis 實測的第三方整理(含 AA-WER Index 數據)
- The Decoder:Mistral launches Voxtral 3
- The Circuitry:Mistral launches Voxtral 3 speech models and voice agent SDK(定價細節)
- Technobezz:Mistral AI Launches Voxtral 3 With Voice Agent SDK
圖片來源及授權:本文配圖由 HKAIWeb 以 Pillow 及 Noto Sans CJK 原創繪製,授權 CC BY 4.0,由 HKAIWeb 署名。圖中資料整理自 Mistral 官方公告及 Artificial Analysis 公開評測,屬事實性資料彙總,不含任何第三方圖片。