
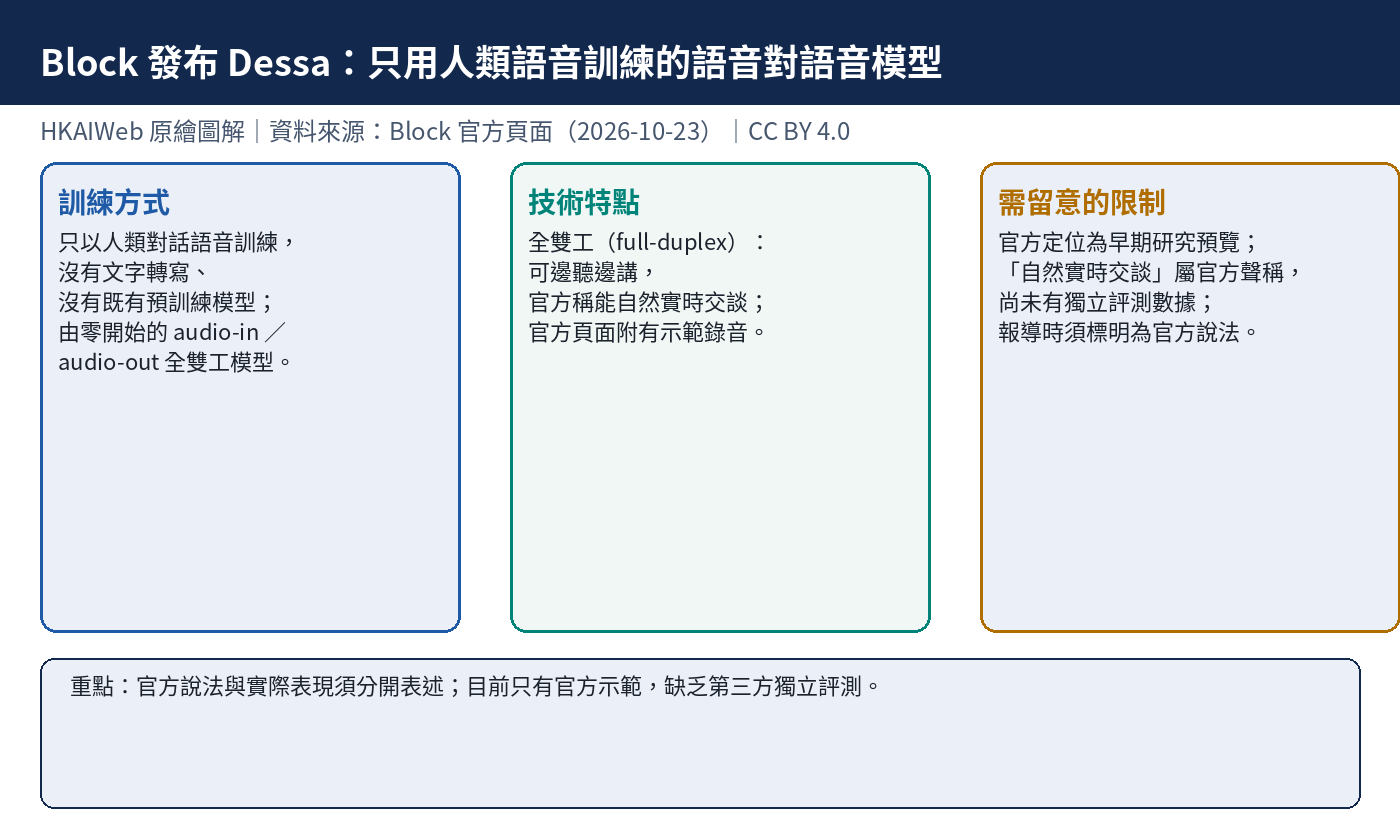
Block 發表名為 Dessa 的語音模型,最大特點是訓練數據只用人類對話語音:沒有文字轉寫、沒有沿用既有預訓練模型,由零開始訓練一個 audio-in/audio-out 的全雙工(full-duplex)模型。
官方頁面實際說了甚麼
根據 Block 官方 Dessa 頁面,模型以人類對話聲音從零訓練,輸入與輸出均為語音;官方稱模型能自然地實時交談,並在頁面附有示範錄音。官方同時把 Dessa 定位為研究預覽,而非已量產的產品功能。
為何值得留意
主流語音助手絕大多數走「語音轉文字→大型語言模型→文字轉語音」的管線,Dessa 的做法等於把整條管線換成單一模型處理。若全雙工與「只聽不說錯」的能力成立,延遲與韻律表現理論上會比三段式管線更接近真人對話;這也是它值得記錄的原因。
仍未確定的地方
「能自然實時交談」屬官方聲稱,頁面只有示範錄音,沒有公開的延遲數字、準確率評測或與現有方案的比較。官方未有公佈模型規模、訓練語料時長、是否開源,以及正式產品的推出時間。在獨立評測出現前,以上說法均應標記為官方宣稱。
第一手來源及交叉來源
- Block 官方 Dessa 頁面:block.xyz/dessa
- The Verge:Jack Dorsey’s Block made an AI model that talks to you like an awkward new friend
- Unite.AI:Block Unveils Dessa, a Full-Duplex Speech Model Trained Only on Conversation
- AI Chat Daily:Block Unveils Dessa Full-Duplex Voice Model Trained Only
圖片來源及授權:HKAIWeb 原創繪製(Pillow + Noto Sans CJK),CC BY 4.0;未使用 Block 官方圖片或第三方圖庫圖片。