
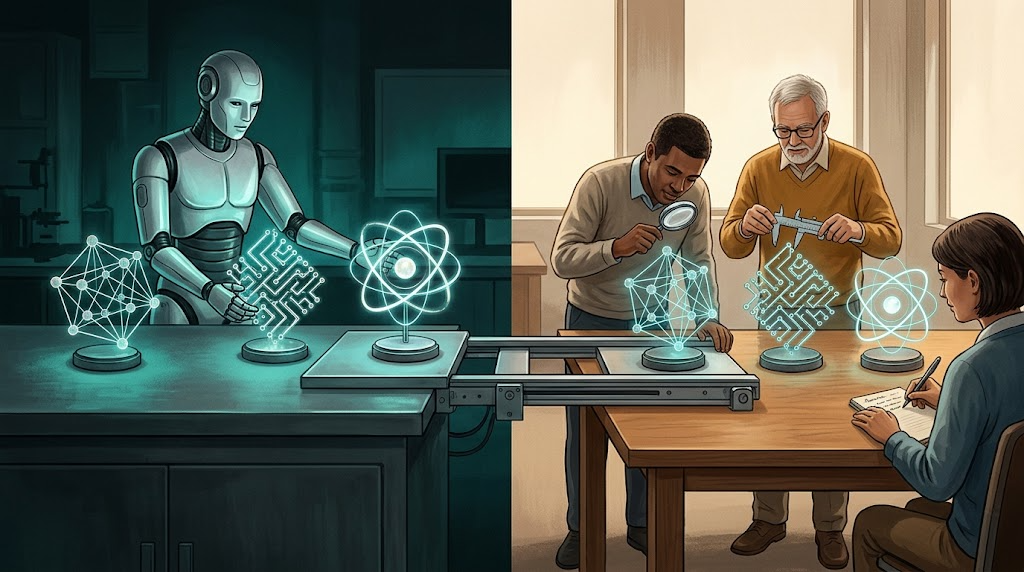
OpenAI 在 10 月 26 日的官方發布中,公布三項由其模型推導的科學成果,涵蓋數學、電腦科學與物理三個方向。與一般「模型答題」示範不同,今次的安排是由外部學者群體擔任「牧羊人」(shepherds),引導研究方向、檢查證明步驟,並保留對成果的詮釋權。
三項成果的範圍
數學方面,模型給出局部平滑(local smoothing)方向的證明工作,涉及 Kakeya 與 Stein 估計;電腦科學方面,一項反例以 Lean 證明形式化,並交由外部專家檢視;物理方面,官方談及四維 Yang–Mills/量子色動力學(QCD)/標準模型的存在性問題。
這三項都屬官方公布的「模型導出結果」,而非已發表並完成同行評審的論文成果。OpenAI 在同一份發布中說明,外部專家群體會在過程中提供指引,並對模型產出的內容作獨立詮釋。
「牧羊」機制:外部專家引導與詮釋
The Decoder 報道,今次參與檢查的外部專家包括諾貝爾獎得主,焦點正是由人帶領模型去完成可被檢視的證明工作。這個模式的意義在於:模型負責產生候選證明與探索方向,外部群體負責提出問題、修正步驟,並決定成果如何被表述。
對讀者而言,這代表評估這類成果時應把「模型輸出」與「社群認可」分開看待。官方頁面列出成果與合作方式,但完整可核對的技術細節仍待學術社群發表。
物理部分:材料暫未公開
官方表示,物理相關的 artifacts 會留待對應的學術論文發布時一併公開。換言之,目前第三方無法直接檢查這部分的推導過程,只能從官方敘述理解其範圍。
因此現階段較準確的定位是:這是 OpenAI 公布、並已安排外部學者群體審閱與詮釋的三項成果,而不是已獲社群定論的科學發現。
為何值得留意
AI for Science 的重心正由「自動生成答案」轉向「可被外部專家檢查的人機協作流程」。如果這套「牧羊」安排在數學與電腦科學案例中運作良好,它意味模型可以承擔更多可形式化驗證的研究工作。
同時要留意的是,官方成果同時具備廠商自述性質:目前未見公開 benchmark、第三方重現或完整 artifacts,物理部分亦未釋出。在學術論文與社群審閱結果出現之前,評估宜以「有外部專家參與的初步結果」看待。
資料來源
- OpenAI 官方:Building scientific understanding with academic communities
- The Decoder:OpenAI 邀外部專家(含諾貝爾獎得主)檢查 AI 產生的證明
- The Verge:OpenAI 在數學、電腦科學與物理成果上的外部審閱安排