
DeepSeek 10 月 17 日公布 V4.1 Flash-1017 更新,稱新版本已在其網站、App 及 API 上線,並向 Hugging Face 和 ModelScope 發放開放權重。官方把它定位為較上一版更快完成任務、輸出更短及成本效率更高的更新,但相關 benchmark 目前主要仍是供應商自報數據。
模型更新與開放權重
DeepSeek 的模型卡把 V4.1 Flash-1017 描述為一個小幅版本更新,列出推理、編程、代理任務及視覺 benchmark 的改善。模型卡亦列出 1M tokens context window、最高至少 256K max tokens 的建議設定,以及 MIT 授權。這些數字反映官方測試設定,不能直接等同所有硬件、harness 或提示下的實際表現。
官方文件同時提到以自我回饋強化學習改善端到端專案開發,並列出遊戲製作、3D 建模及 Godot 專案等示範。對開發者而言,開放權重加上參考 encoding 實作,意味著可以自行研究推理與工具整合;但模型推理、工具執行和 HTTP 傳輸仍需由部署者自行處理。
Search & Fetch API 開放
今次更新另一個重點是 Search 與 Fetch API 向所有人開放。DeepSeek 文件列出的價格是每個 endpoint 每 1,000 次呼叫 0.75 美元;透過 DeepSeek Harness、Claude Code 及 Codex 的 server-side tools,在 2026 年 10 月 31 日 16:00 UTC 開始計費前,對 DeepSeek API 用戶暫時免費。
The Decoder 及 Vercel 的資料確認了模型在第三方平台和代理工作流的可用性,但沒有獨立重跑 DeepSeek 模型卡的全部 benchmark。實際採用時,應分開評估開源授權、推理成本、資料外傳風險和工具 API 的計費邊界。
為何值得留意
這次發布把開放權重模型、長 context 和內置搜尋工具放在同一個更新中,對需要本地部署或代理式編程的開發者較有吸引力;同時,1M context 和 benchmark 優勢仍屬官方聲稱,未來要以可重現測試及實際 API 帳單驗證。
來源
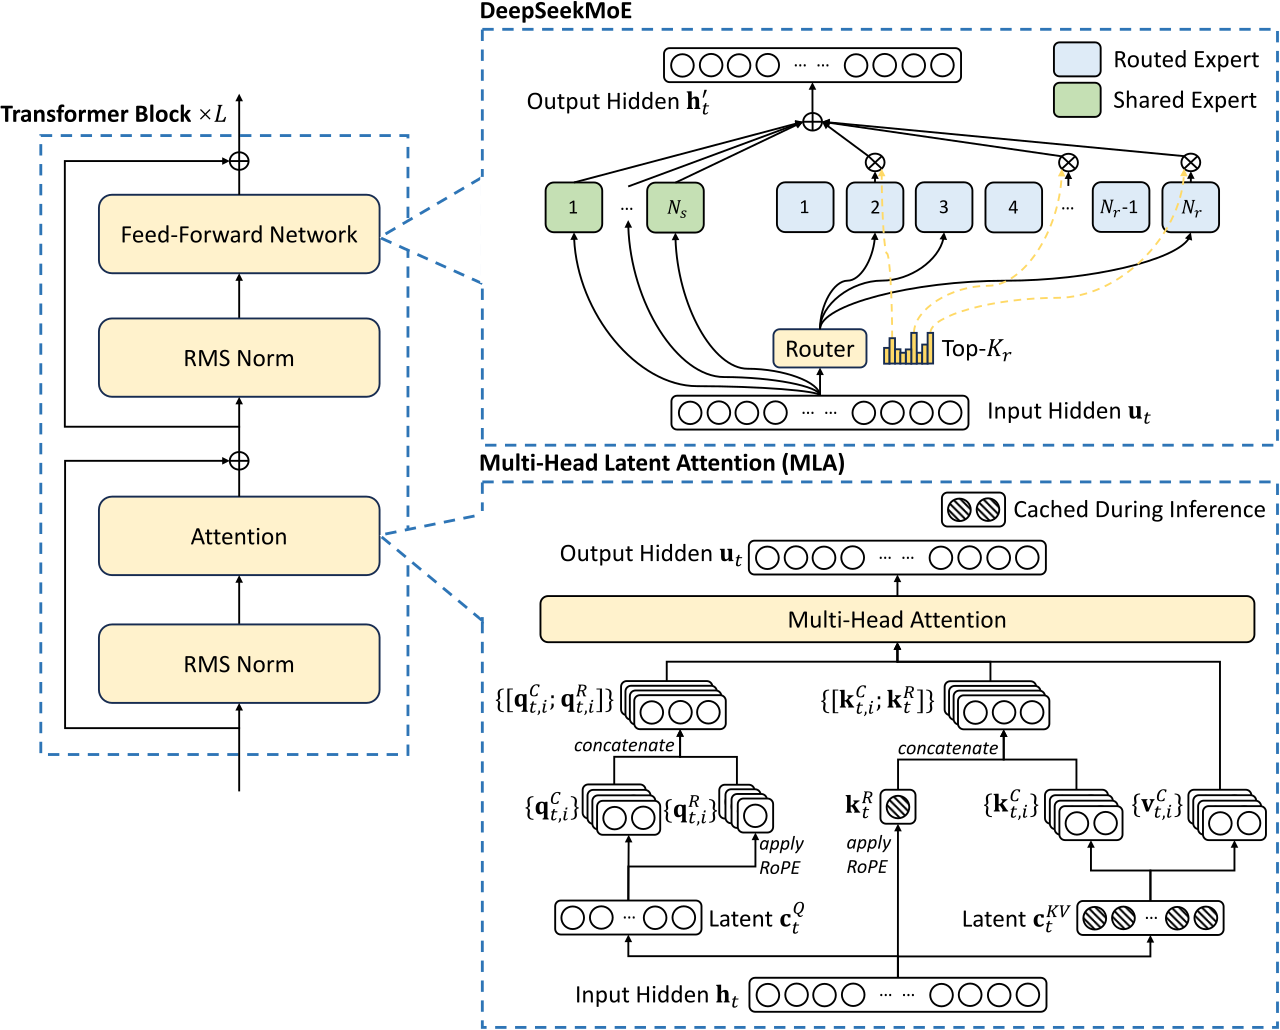
圖片來源及授權: Wikimedia Commons:DeepSeek MoE and MLA (DeepSeek-V2).svg,來源 DeepSeek、作者 DeepSeek,MIT License。這是 V2 架構圖,並非 V4.1 Flash-1017 的產品截圖;本文保留來源及授權連結。
