
Meta 的商業條款預覽頁顯示,新版本將於 2026 年 10 月 30 日生效。條款目前仍寫明,Meta 可使用與商業帳戶產品及服務相關的內容,以提供、開發、改善、研究及維護這些產品;但在今次更新後,曾被外界解讀為容許把網域內容用於 AI 訓練的 train 字眼已不再出現在相關句子。
官方條文與外界解讀要分開
The Verge 10 月 17 日報道,Meta 在受到反彈後移除了會被理解為可抓取新聞網站內容訓練 AI 的文字。報道同時引述 Meta 代表 Andy Stone 及 Daniel Roberts,指這次清只涉及廣告及商業產品,並稱爬蟲使用方式沒有改變;內容擁有人仍可用 robots.txt 表達偏好。
因此,這次變動不應簡化成「Meta 已停止爬取」或「條款已確認可以免費訓練」。可核對的事實是:預覽條款把用途描述收窄到商業產品相關範圍,生效日期是 10 月 30 日;至於網頁抓取、robots.txt、版權及 AI 訓練之間的法律效果,Ars Technica、Nieman Lab 及 The Verge 引述的法律分析仍有不同解讀。
對網站及商業帳戶持有人的影響
對經營新聞網站、品牌頁面或廣告素材的團隊,重點是不要只看條款中的單一動詞。應同時保存生效前後版本,檢查所用的 Meta 產品、第三方代理和 robots.txt 設定,並在需要時尋求法律意見。條款文字移除 train 並不會自動解決 Meta 取得內容的授權範圍,也不會取代各網站自己的存取政策。
這宗事件值得留意,是因為大型平台如何描述爬蟲、內容授權及 AI 產品用途,會直接影響出版者與平台之間的談判空間。下一個觀察點是 10 月 30 日正式條款、Meta 的後續說明,以及是否有監管或訴訟文件提出更明確的解釋。
來源
- Meta 商業條款預覽(顯示 2026-10-30 生效)
- Meta 商業條款更新說明
- The Verge 報道(2026-10-17)
- Ars Technica 分析
- Nieman Lab 法律分析
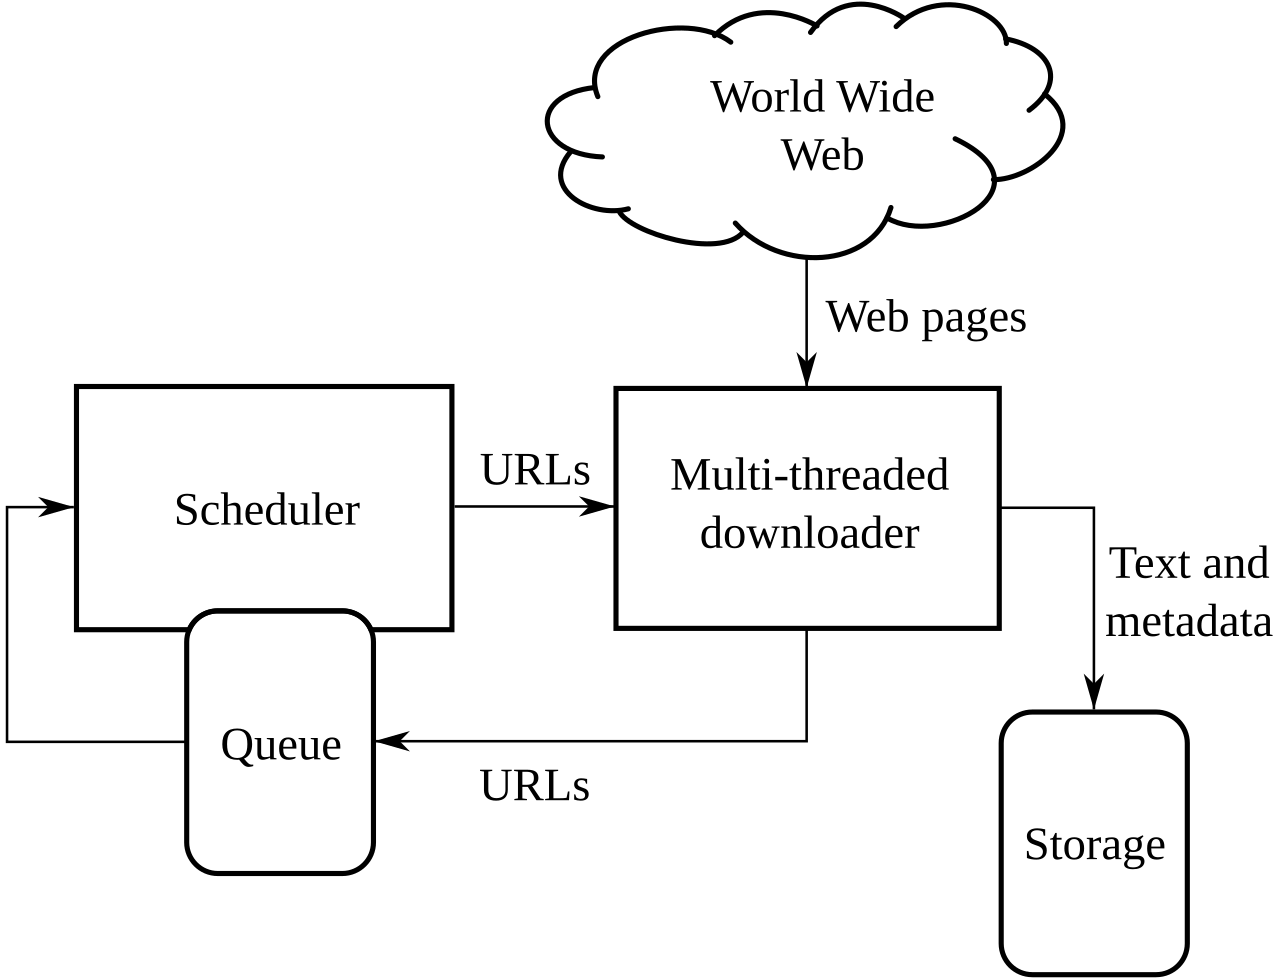
圖片來源及授權: Wikimedia Commons:WebCrawlerArchitecture.svg,dnet(基於 Carlos Castillo 公開作品),CC BY-SA 3.0。這是通用網絡爬蟲架構圖,不是 Meta 產品截圖;本文列出作者、來源及授權連結。
